 Design
Codice da Figma con l'AI: cosa va online e cosa si riscrive
Gli strumenti AI da Figma al codice azzeccano layout e testi. Token, stati, componenti e semantica si riscrivono: 541 errori di accessibilità in 300 interfacce.
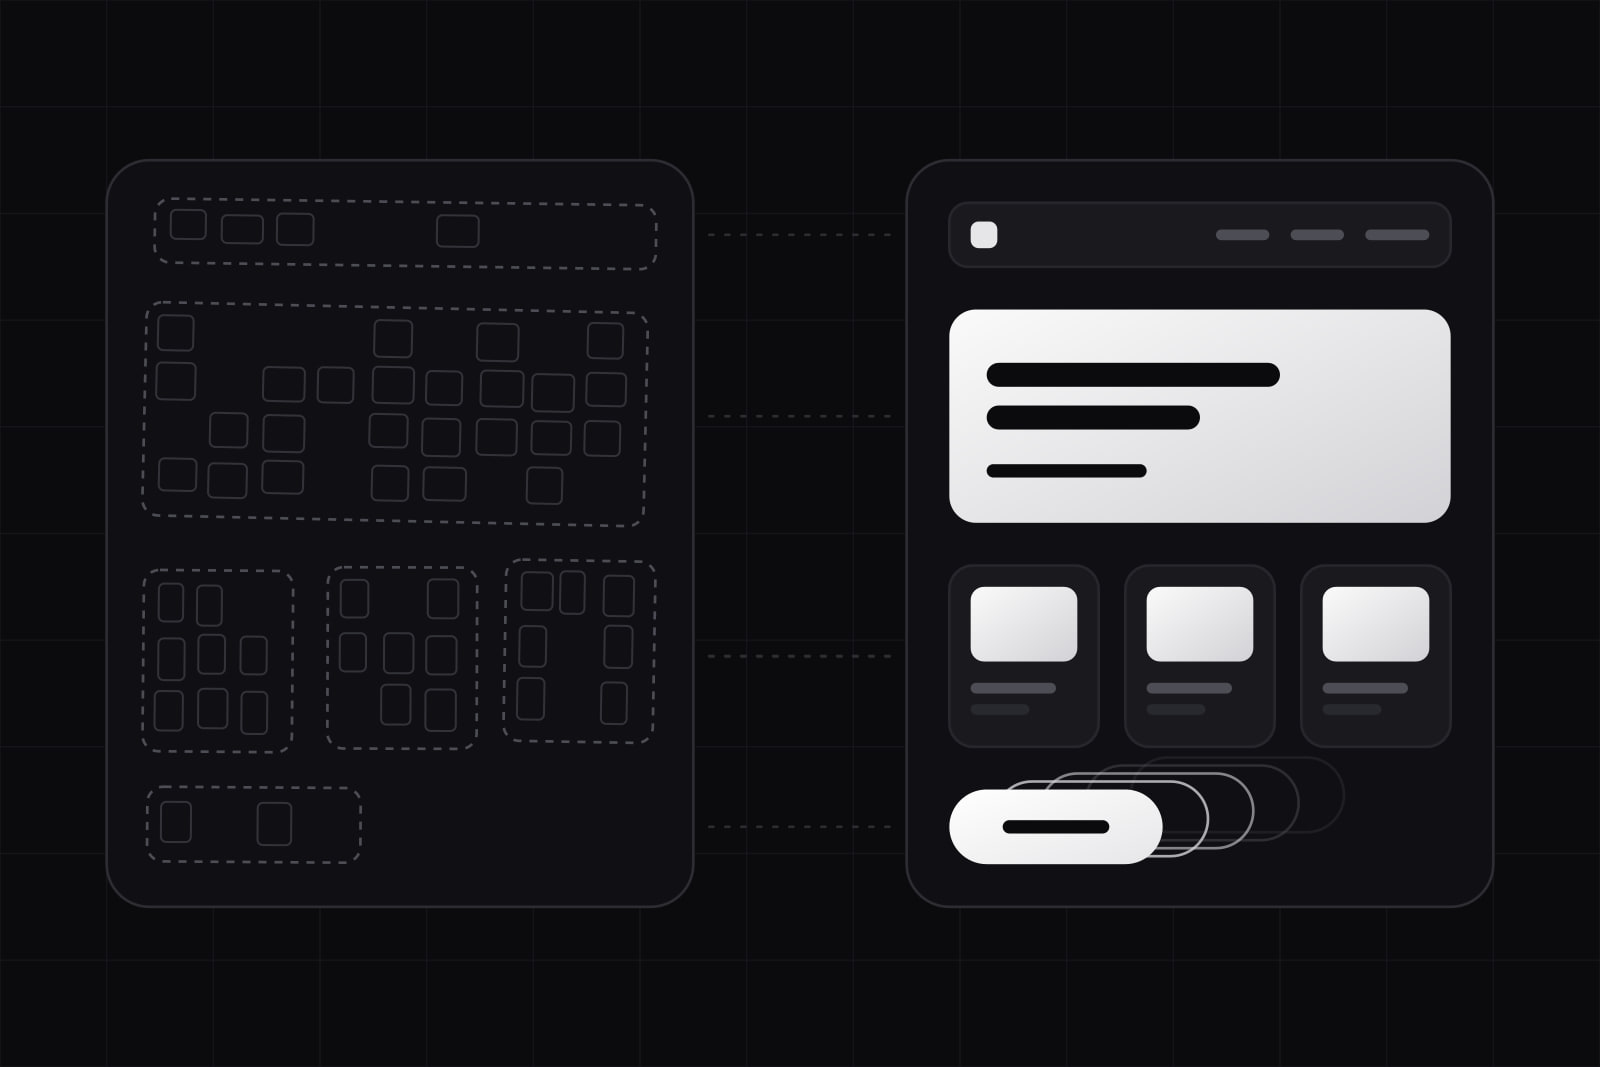
Il codice che un'AI genera da Figma è il markup che un agente o un plugin scrive partendo da un frame. Riproduce il layout e i testi della schermata. Lascia fuori quasi tutto ciò che serve per rilasciare un componente senza rischi: i token, gli stati, la semantica e il collegamento ai componenti che il codice ha già.
La domanda riguarda ogni team che ha un design system e deve decidere quanto fidarsi di questi strumenti nel 2026. In uno screenshot il risultato sembra finito, ed è lì la trappola. Qui sotto mettiamo a confronto, voce per voce, cosa generano gli strumenti e cosa serve al codice di produzione, partendo dalla documentazione di Figma e dalle ricerche pubblicate finora.
In breve: la struttura si tiene, lo stile si riscrive, gli elementi diventano componenti della tua libreria e ogni stato si scrive a mano. Il codice generato è una prima bozza veloce del layout. Come prima bozza di un componente vale poco.
Cosa contiene davvero il codice generato da Figma?
Lo producono tre tipi di strumenti. Gli agenti collegati al server MCP di Figma leggono il file direttamente. I plugin di esportazione convertono il frame selezionato in React, Vue o HTML. I modelli screenshot-to-code lavorano su un'immagine della schermata e il file non lo vedono affatto.
Il server MCP di Figma è il più chiaro su cosa restituisce. Il suo strumento principale, get_design_context, passa all'agente una rappresentazione strutturata in React e Tailwind della selezione, e la guida di Figma chiede di trattarla come una rappresentazione del design e del comportamento, non come lo stile definitivo del codice. Un secondo strumento, get_variable_defs, elenca le variabili usate nella selezione, così l'agente può richiamare i token al posto dei valori grezzi. Entrambi portano solo quello che c'è nel file. Un frame senza variabili né auto layout consegna all'agente codici esadecimali e posizioni assolute.
Lo screenshot-to-code parte con meno. Il benchmark Design2Code ha messo alla prova i modelli multimodali su 484 pagine web reali: restano indietro soprattutto in due punti, cioè nel riportare tutti gli elementi visivi della pagina e nel ricostruire il layout corretto. Uno screenshot non ha nomi dei livelli, variabili o confini dei componenti, e il modello deve dedurli tutti e tre.
Codice generato e codice rilasciato, voce per voce
La distanza si vede meglio un aspetto alla volta. A sinistra c'è quello che di solito esce da un file Figma ben strutturato, passando da un agente o da un plugin. A destra c'è quello che serve alla stessa schermata prima del merge.
| Aspetto | Cosa ha il codice generato | Cosa serve al codice rilasciato |
|---|---|---|
| Layout | Flex e grid dedotti dall'auto layout; posizioni assolute dove l'auto layout manca | Le primitive di layout che il codice usa già (Stack, Grid, Container) |
| Colori e spaziature | Le variabili, se il file le ha; altrimenti esadecimali e pixel | Solo token semantici, mai un valore grezzo |
| Componenti | Markup nuovo per ogni pulsante e campo, a meno che Code Connect non li colleghi | Import dei componenti esistenti con le loro prop reali |
| Tipografia | Dimensione, peso e interlinea copiati livello per livello | La scala tipografica come stili con un nome |
| Stati | L'unico stato disegnato nel frame | Hover, focus, attivo, disabilitato, caricamento, vuoto ed errore |
| Semantica | Div e span, alt text generici, link con etichette vaghe | Landmark, titoli in ordine, controlli con etichetta, alt text che descrive |
| Comportamento responsive | Il breakpoint che è stato disegnato | Tutti i breakpoint, con testi che vanno a capo e contenuti che crescono |
| Dati e comportamento | Testo statico preso dal file | Prop, dati caricati dal server, validazione, eventi |
Dove il codice generato si può tenere
Una parte supera la revisione quasi intatta, ed è proprio quella che prima costava più battitura.
- L'annidamento. Se il file usa l'auto layout con gap, padding e direzione impostati, la struttura flex dedotta di solito è giusta. La guida MCP indica l'auto layout come il modo per comunicare l'intento responsive proprio per questo.
- I testi e il loro ordine. Titoli, etichette e paragrafi arrivano come sono stati scritti, nell'ordine di lettura.
- Le sezioni uniche. Una fascia marketing che esiste una volta sola, senza stati e senza dati, va online quasi come è stata generata, una volta sostituiti i valori con i token.
- I prototipi. Una schermata fatta per provare un'idea con cinque utenti non ha bisogno di stati di focus né di una scala tipografica. Il codice generato basta.
Dove il codice generato si riscrive
Token e valori grezzi
Un agente richiama un token come color.surface.raised solo se il frame usava quella variabile. Ogni livello riempito con un colore scelto a occhio diventa un esadecimale, ogni spaziatura impostata trascinando diventa un valore in pixel. La revisione del codice si trasforma in una caccia ai numeri. Abbiamo spiegato perché i token sono una decisione a parte in design token, variabili CSS e Tailwind.
Componenti
Senza una mappatura, l'agente ricostruisce ogni pulsante dai suoi rettangoli e dalla sua etichetta. Su Code Connect la guida di Figma è netta: senza, il modello tira a indovinare. Anche con la mappatura, l'agente sceglie le prop da quello che vede, e un componente con un'API troppo larga si presta a combinazioni sbagliate. Prop strette, come nelle nostre sei regole, riducono lo spazio per l'errore.
Stati
Un frame è un solo momento di un componente. Il codice generato riproduce quel momento e nient'altro: niente anello di focus, niente aspetto disabilitato, nessun percorso di caricamento o di errore. È negli stati che si nasconde la maggior parte dei bug di interfaccia, e nessuno strumento genera uno stato che nessuno ha disegnato.
Semantica e accessibilità
È la distanza che i controlli automatici non vedono. Uno studio presentato a CHI 2026 da Calo, Gurita e De Russis ha generato 300 interfacce web con tre modelli commerciali e ha trovato 541 violazioni di accessibilità semantica, divise in sei tipi di errore, circa 1,8 per interfaccia: alt text che non descrivono nulla, link dallo scopo poco chiaro, titoli che non corrispondono al contenuto. Un'immagine con alt="image" supera qualsiasi controllo automatico. Un confronto tra codice web scritto da LLM e da persone mostra che i modelli gestiscono bene contrasto e alt text e faticano con gli attributi ARIA. Prima del rilascio, l'interfaccia generata ha bisogno di una persona con uno screen reader.
Comportamento responsive
Quasi tutti i frame sono disegnati a una o due larghezze. Il codice segue quelle larghezze e per le altre procede per ipotesi: stringhe tradotte lunghe, immagini mancanti e liste vuote sono le prime a rivelarlo.
Perché l'ultimo tratto costa più del primo
Addy Osmani lo chiama il problema del 70%: l'AI ti porta in fretta quasi alla fine, e la parte che resta richiede più tempo del primo 70%. Aggiunge che prompt, specifiche e contesto migliori spingono la quota forse all'80-85 percento, poi il guadagno cala. Dal design al codice la curva è la stessa. Quello che gli strumenti coprono è la parte visibile: riquadri, spaziature, testi. Quello che resta alle persone è la parte invisibile: token, stati, semantica, comportamento. Va letta riga per riga, perché nel browser sembra giusta finché qualcuno non ci naviga con la tastiera.
In pratica il costo cambia posto. Il codice generato fa risparmiare battitura e aggiunge revisione. Chi lo mette in produzione così com'è paga dopo, con il component drift: tre pulsanti leggermente diversi, ognuno corretto il giorno in cui è uscito.
Come lo usiamo noi
Per noi il codice generato è una specifica del layout, mai codice da unire al ramo principale. La sequenza su un progetto con design system:
- Una sezione alla volta. Una card, un header, un form. Con selezioni più piccole l'agente ha meno da indovinare. La configurazione è nella nostra guida al passaggio con Figma MCP.
- Prima i componenti esistenti. Le istruzioni dell'agente nominano la libreria di componenti e vietano markup nuovo per tutto ciò che la libreria copre già, come nelle nostre regole di governance per gli agenti.
- Nessun valore grezzo. Una regola di lint blocca la build se trova un esadecimale o un valore in pixel fuori dai file dei token.
- Gli stati si scrivono a mano, partendo dal contratto del componente e non dal frame.
- La semantica si verifica ascoltando. Prima gli audit automatici, poi un passaggio con tastiera e screen reader su ogni schermata nuova.
Il tempo risparmiato nei primi due passi è reale. Nei passi dal terzo al quinto si spendono le ore, e lì si decide la qualità del prodotto finito.
Come valutare uno strumento prima di adottarlo
Le demo dei fornitori usano file puliti e un solo stato. Un test più onesto richiede un pomeriggio. Scegli una schermata reale del prodotto, con almeno tre stati e un form. Generala con lo strumento. Poi conta quattro cose nel risultato: valori grezzi che dovrebbero essere token, elementi che duplicano un componente esistente, stati mancanti ed errori semantici trovati con uno screen reader. Infine misura quanto tempo serve perché il codice arrivi a una pull request approvata.
È quest'ultimo numero che conta. Uno strumento che produce in un minuto una schermata identica al pixel e poi un giorno di correzioni fa risparmiare meno di uno che produce una schermata più grezza ma fatta dei componenti giusti. Ripeti il test dopo aver sistemato il file Figma: di solito il punteggio cambia più con il file che con lo strumento.
Domande frequenti
No, e le ricerche indicano dove passa il confine. Gli strumenti coprono bene la parte visibile di una schermata: riquadri, spaziature e testi. Mancano gli stati che nessuno ha disegnato, la semantica che i controlli automatici non vedono e il collegamento con una libreria di componenti esistente. Lo sviluppatore decide ancora quale componente usare, scrive i percorsi di caricamento e di errore e rivede il risultato con tastiera e screen reader. Cambia come passa la giornata: meno layout da battere, più revisione.
Risolve la distanza più grande, il riuso dei componenti, e nient'altro. Con Code Connect l'agente importa il tuo Button invece di ricostruirlo dai rettangoli. Però sceglie ancora le prop da quello che mostra il frame, vede ancora solo lo stato disegnato e non sa nulla dell'accessibilità che il file non contiene. Per un team con una libreria di componenti conviene configurarlo, ma la revisione di stati e semantica resta lunga uguale.
Per il lavoro di produzione, di solito sì. Uno screenshot contiene solo pixel: niente nomi dei livelli, variabili, auto layout o confini dei componenti, quindi il modello deve dedurre la struttura, e il benchmark Design2Code ha trovato proprio nel layout e negli elementi i punti più deboli. Generando dal file con il server MCP di Figma, l'agente ha variabili e intento del layout su cui lavorare. Lo screenshot-to-code ha ancora senso per ricreare una pagina di cui non hai il file, per esempio un vecchio sito da rifare.
Servizi correlati
Articoli correlati
Design Design
 token multi-brand: 6 passi da un solo livello di primitive
Un livello di primitive, un file di soli alias per ogni brand, componenti che leggono solo nomi semantici: sei passi sulla specifica DTCG 2025.10 e su Figma. AI